Transformer 详解:一句中文怎么流过一层编码器
本文主要参考 Jay Alammar 的 The Illustrated Transformer ,并结合原论文《Attention Is All You Need》整理,用于后续学习及复习的备份。
除整体结构示意图外,文中配图来自 Jay Alammar 原文,版权归原作者所有。
一、先搞清楚为什么要它
在 Transformer 之前,机器翻译的主流是 RNN(LSTM / GRU)的编码器-解码器结构。它有两个绕不开的问题。
一是顺序依赖,无法并行。 第 t 个词的计算必须等第 t-1 个词的隐状态算完,一条句子的训练时间随长度线性增长,GPU 的并行能力基本用不上。
二是长距离依赖衰减。 信息要沿着时间步一步步传,句子一长,开头的信息传到结尾已经被稀释得差不多。
注意力机制最初是作为补丁出现的:让解码器在生成每个词时,直接回看编码器的全部位置,而不只是依赖最后一个隐状态。Transformer 的激进之处在于——把循环结构整个扔掉,只留注意力。论文标题说得很直白:Attention Is All You Need。
Jay Alammar 那篇图解里有一句话说到了点子上:它最大的好处不是精度,而是天然适合并行化。
二、整体结构
完整的 Transformer 由编码组件、解码组件以及连接二者的中间层组成。编码组件由 6 层编码器首尾相接堆叠而成,解码组件同样由 6 层解码器堆叠而成。
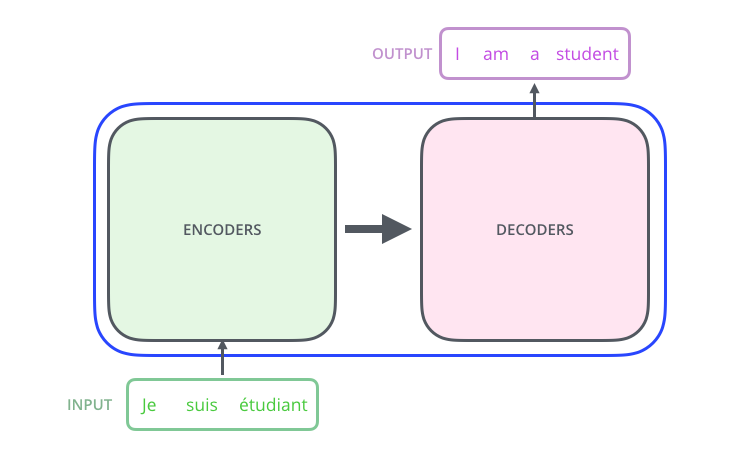
这里的 6 没有任何神秘之处,只是一个可以调整的超参数。
每一层编码器的结构完全相同(但权重不共享),包含两个子层:
- 多头自注意力(multi-head self-attention)
- 前馈神经网络(feed-forward network)
解码器多一个子层,夹在两者之间:编码器-解码器注意力(cross-attention)。
为便于理解,先只看一层编码器与一层解码器的情况:
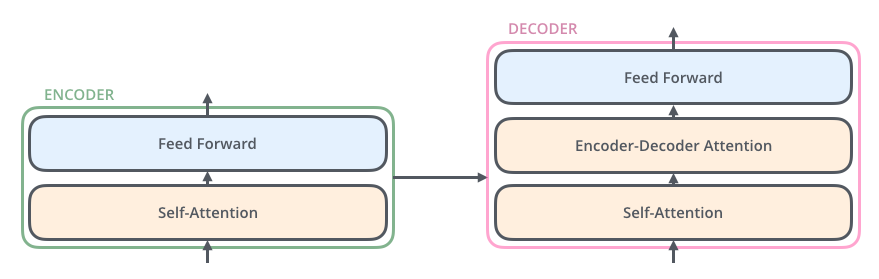
编码器的输入首先进入 self-attention 层。在编码输入句子中的某个词时,该层会把句中其他词的信息一并纳入。self-attention 层的输出随后送入前馈神经网络;句中不同位置的输出各自独立地通过同一个前馈网络。解码器同样包含这两层结构,只是在两者之间额外插入了一个 attention 层,用于让解码器聚焦于输入句子中的相关部分。
三、从一句话到矩阵
第一步,分词。 取句子「今天我要上学了。」,在首尾分别加上起止符,得到「[BOS]今天我要上学了。[EOS]」,共 10 个 token。
这里按单字切分。如果换成按词切分(今天 / 我 / 要 / 上学 / 了 / 。),token 数就不是 10,后面所有维度都要跟着变。所以这个前提得先讲清楚。
第二步,词嵌入。 每个 token 映射成一个 512 维向量,整句得到 10×512 的矩阵,这就是计算机可处理的句子表示。
第三步,位置编码。 这一步在很多图解里被略过,但它是 Transformer 能扔掉 RNN 的关键,必须单独说。
为什么必须加。 自注意力本质是「对所有位置做加权求和」,它对顺序完全无感。如果只把词嵌入喂进去,「我打你」和「你打我」在模型眼里是同一个东西——注意力输出的只是几个词向量的重新加权组合,交换顺序不改变结果。
怎么做。 为每个位置准备一个 512 维的位置向量,直接加到词嵌入上:
X = Embedding(tokens) + PositionalEncoding
论文用的是不同频率的正弦和余弦函数。这样设计的好处是位置编码不依赖具体长度——训练时见过长度 512 的句子,推理时遇到更长的也能算出来。
加完之后 X 仍然是 10×512,但每个位置已经带上了「我在第几个」的信息。
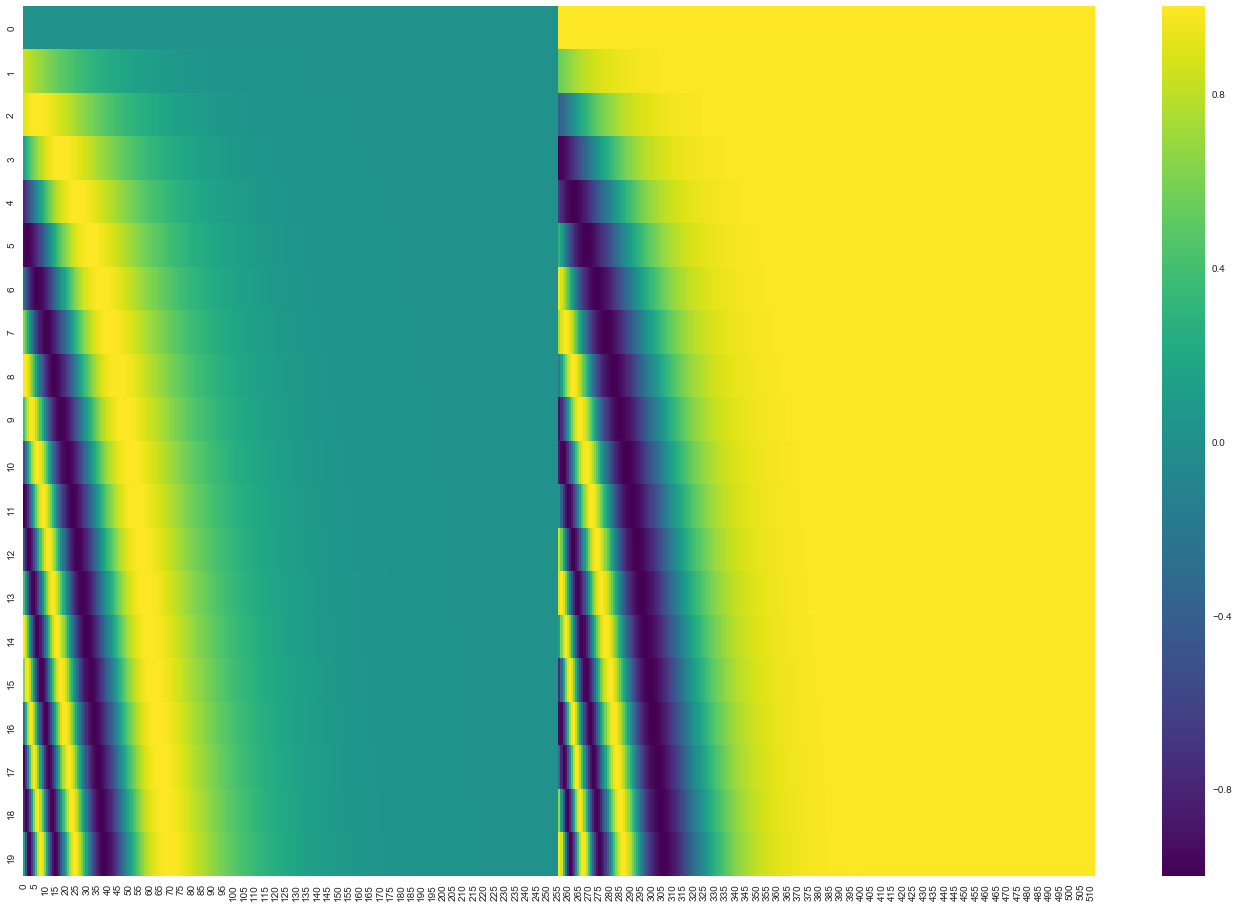
下图是 20 个位置、每个位置 512 维的位置编码矩阵:纵轴是位置,横轴是维度,颜色深浅就是编码值。左半边由正弦函数生成、右半边由余弦函数生成,你会看到规则的明暗条纹——正是这种周期性结构,让模型能通过线性变换反推出两个位置之间的相对距离。
四、Self-Attention 的六步
先看它到底在解决什么问题。在「The animal didn't cross the street because it was too tired」这句里,要判断 "it" 指的是 street 还是 animal,对人类是一眼的事,对算法却不是。自注意力让模型在处理 "it" 时,把一部分注意力分给 "animal",并把它的表征融进 "it" 的编码里:
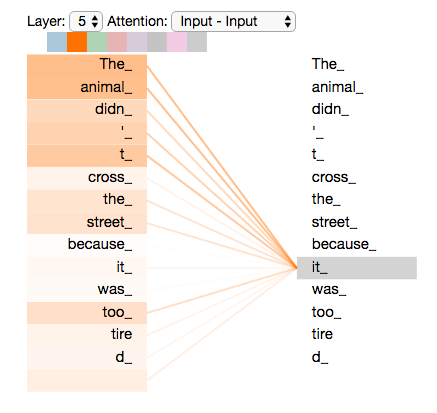
这张图截的是第 5 层编码器、Input-Input 的注意力:纵轴是「谁在发问」,横轴是「它在看谁」。处理 "it" 时,权重明显落在 "The animal" 和 "tired" 上——颜色越深,说明分配给那个词的注意力越多。
下面用矩阵形式走一遍完整计算。
① 生成 Q、K、V。 把 10×512 的 X 分别乘以三个可训练的权重矩阵 WQ、WK、WV(假设维度 512×64),得到三个 10×64 的矩阵。
原论文的设定是 512 → 64,而不是 64 → 512,原因是让 8 个头的总计算量与单个全维度头大致相当。这三个矩阵的分工是:
- Q(Query):这个位置想找什么
- K(Key):这个位置能被什么找到
- V(Value):这个位置实际携带的信息
需要说明的是,Q/K/V 并不是三个有明确物理含义的东西,它们只是让注意力这件事可以被计算、被思考的抽象。市面上常见的「查字典」类比(Query 是要查的词,Key 是索引,Value 是词条内容)有助于入门,但它既不是原论文的说法,也不是 Jay Alammar 原文的说法,别当成定义用。
② 算分数。 Q 乘以 K 的转置,得到 10×10 的矩阵。第 i 行第 j 列,就是第 i 个词对第 j 个词的关注程度。
③ 缩放。 除以 √dk,dk=64 时就是除以 8。
注意这个 8 来自 √64,和注意力头的数量没有任何关系,只是论文的默认配置让两者数值恰好相同。如果每个头是 128 维,除的就是 √128 ≈ 11.3;哪怕头数改成 16,只要每头还是 64 维,除的依然是 8。
为什么要这一步?假设 q、k 的每个分量都是均值 0、方差 1 的独立随机变量,那么 q·k 是 64 个乘积之和,方差约为 64,标准差就是 8。项数够多,中心极限定理会把和拉成近似正态,按 3σ 规则,99.7% 的分数会落在 ±24 之内。
问题在于 softmax 对分数的整体平移不敏感,敏感的是分数之间的差。两个词的分数一个 +24、一个 −24,差 48,指数比达到 e^48 ≈ 7×10^20。softmax 之后,一个词的概率几乎是 1,其余全是 0——分布变成 one-hot,而 softmax 在饱和区的导数趋近于 0,梯度也就没了,这一层学不动。
除以 √dk 把标准差拉回 1,最大分差回到 6 左右。分布仍然偏尖(注意力本来就需要有倾向性),但落在还能传出梯度的范围内。论文的用词很准确:more stable gradients,稳定的是梯度,不是「注意力质量」。
顺带解释为什么不除以 dk:方差是 dk、标准差才是 √dk,要抵消方差就得除标准差。除以 dk 会把方差压到 1/dk,反而过小,softmax 变得过平,注意力失去区分能力。
④ softmax。 按行归一化,每行变成和为 1 的概率分布,表示「这个词应该把多少注意力分给各个位置」。
⑤ 加权。 用这个 10×10 的权重矩阵乘以 10×64 的 V,得到 10×64 的输出。
⑥ 求和。 这一步已经包含在矩阵乘法里了。
整个过程可以压缩成一行公式:
Attention(Q, K, V) = softmax( QKᵀ / √d_k ) · V
输出矩阵记作 Z,维度 10×64。它和这个词原来的嵌入已经不同了——它是「带着上下文理解的」那个词。
一个直觉:softmax 之后,我们想关注的词权重接近 1,无关的词可能只有 0.001,乘以 V 之后基本被淹没。注意力做的就是这个取舍。
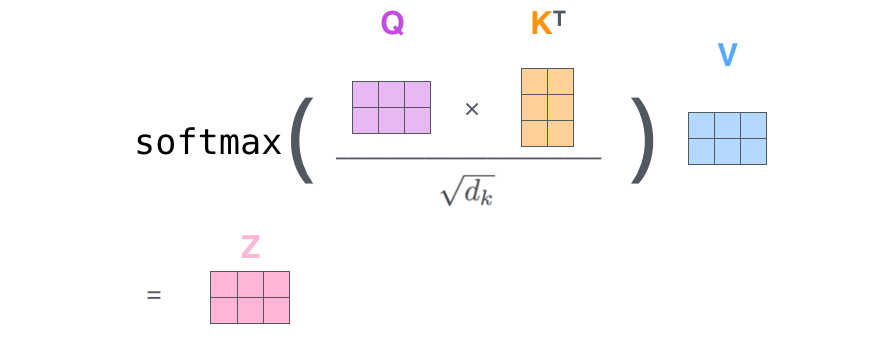
五、多头注意力:为什么是 8 个
只做一次注意力有个问题:一个词自身的信息往往会主导输出。在「The animal didn't cross the street because it was too tired」这句里,如果只有一组权重,"it" 的表征可能大部分还是 "it" 自己。
多头解决两件事:
- 让模型从多个角度同时关注不同位置。 有的头盯着「it → animal」,有的头盯着「it → tired」。
- 提供多个表示子空间。 8 组独立的 WQ/WK/WV,随机初始化,训练后各自把输入投影到不同的子空间。
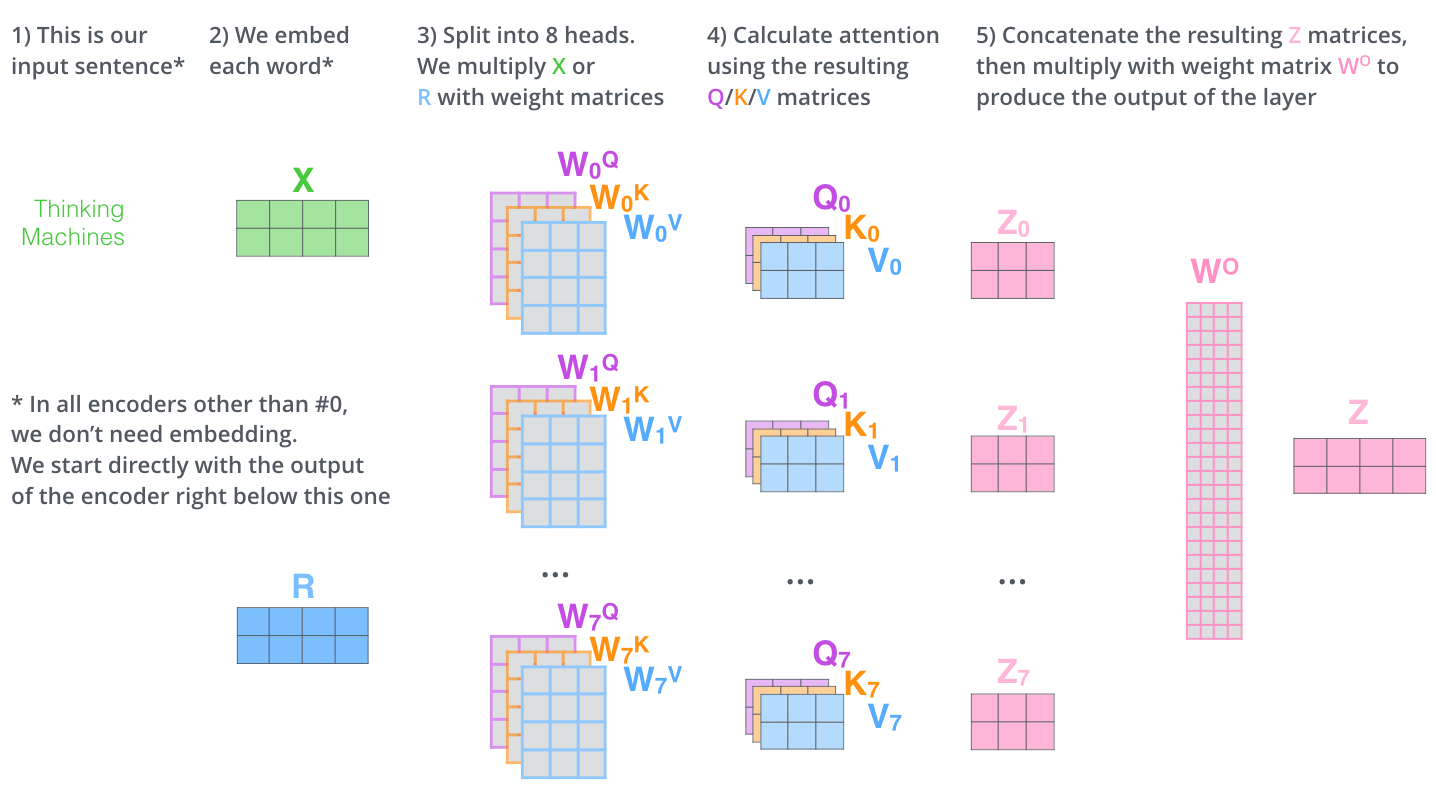
计算上,就是并行做 8 次上面的六步,得到 8 个 10×64 的 Z。
至于为什么正好是 8 个——和编码器的 6 层一样,这也不是规定。论文取 8 头、每头 64 维,总维度仍是 512;实践中 16 头、32 头的配置都很常见,通常只要让「头数 × 每头维度」等于 d_model 就行。头越多,每个头关注的粒度越细,但单头能表达的维度也越少,这是个需要平衡的取舍。
六、8 个头怎么合成一个:输出矩阵 W^O 在做什么
问题随之而来:后面的 FFN 只接受一个矩阵,不接受 8 个。
解法是把这 8 个矩阵横向拼接,得到 10×512(8×64),再右乘一个输出矩阵 WO(512×512),投影回 10×512。
先澄清一个常见的算式错误:8 个头拼接的结果是 8×64 = 512 维,不是一个「拼接后再加一遍原输入」的 1024 或 2560。 残差连接发生在拼接和 WO 投影之后,不在拼接里面,这两件事不能混在一起算。
拼接只是并排,相乘才是混合
这两步做的事完全不同。
拼接只是并排。 拼出来的 512 维里,第 164 维只属于头 1,第 65128 维只属于头 2……八个头各占一段,互不干涉。它们只是被摆在一起,没有发生任何交互。
乘 WO 才是真正的混合。 WO 是稠密矩阵,输出的每一维都是输入 512 维的加权和——输出的第 1 维同时吸收了 8 个头的信息。这一步之后,八个子空间的信息才搅在一起。
有个等价写法能把这件事看得更透。把 WO 按行切成 8 块,每块 64×512,分别记作 WO1 … WO8,那么:
concat(Z₁, …, Z₈) · W^O = Z₁·W^O₁ + Z₂·W^O₂ + … + Z₈·W^O₈
也就是说,拼接后乘一次 512×512,等价于 8 个头各自先投影到 512 维空间,再把结果相加。
所以 W^O 到底是什么
它不是「把 8 个头揉成一团的神秘融合器」,而是 8 个并行的输出投影——每个头各自把自己那 64 维映射到 512 维空间,8 份结果在同一个空间里叠加。叠加这个动作本身不含参数,参数全在那 8 块 64×512 里。
顺带澄清两个常见误解:
- 八个头不是「一人管 64 个维度」。 每个头读的都是完整的 10×512 输入,只是用自己那组投影矩阵看向不同的子空间。所谓多头,是八个不同的投影方向,不是把 512 维切开分给八个人。
- 没有人规定「头 1 管语法、头 2 管指代」。 八组权重都随机初始化,分工是训练中自己分化出来的。可视化时看到某个头偏向 animal、某个头偏向 tired,那是结果,不是设计。
这个是后续的优化部分,原始transformer不共享KV:正因为每个头都在重复读取同一份输入、各算一遍 K 和 V,后来的 multi-query attention 和 grouped-query attention 正是从这里下的手:让多个头共享同一份 K/V,只保留各自的 Q,推理时的 KV cache 因此大幅缩减。
七、残差与 LayerNorm
每个子层的完整形式是:
输出 = LayerNorm( x + Sublayer(x) )
也就是子层的输出先和它的输入相加(残差),再做层归一化。自注意力后有一次,FFN 后又有一次,编码器和解码器都一样。
残差的作用是给梯度留一条直通路径。6 层堆叠时,反向传播要穿过 12 个子层,没有这条捷径,深层网络很难训起来。
LayerNorm 则是对每个 token 的 512 维向量内部做归一化——不是跨 batch,也不是跨序列长度,是逐 token 的。
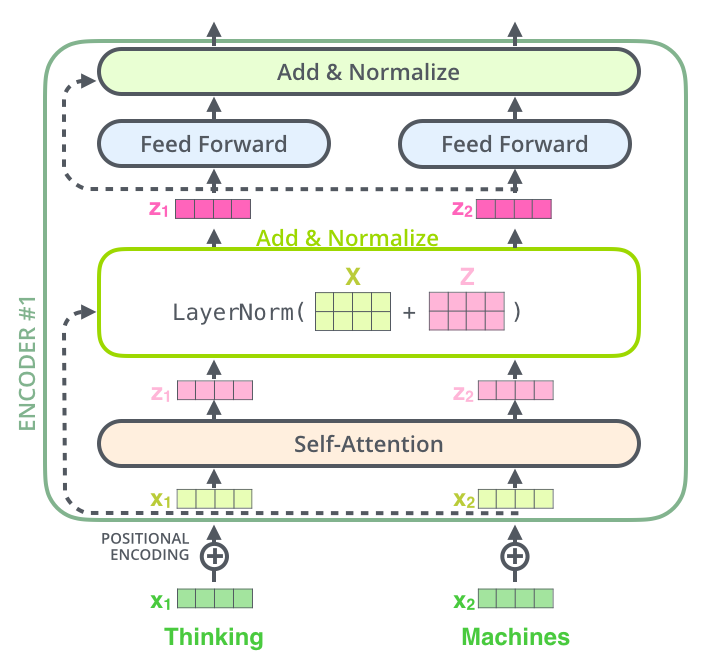
图中左侧的 add & norm 方框就是上面这条公式的可视化:向量从子层出来,与它进来时的副本相加,再统一过一遍归一化。注意残差是加在子层输出上的,不在多头拼接里——这两件事经常被混为一谈。
八、前馈网络
FFN 是逐位置独立作用的两层全连接:
FFN(x) = max(0, xW_1 + b_1) · W_2 + b_2
典型维度是 512 → 2048 → 512,中间接 ReLU(后来的模型多用 GELU)。
「逐位置独立」这点很关键:第 1 个词的 FFN 和第 10 个词的 FFN 之间没有任何信息交换,所以这 10 个位置可以完全并行。整个 Transformer 里,只有注意力层存在跨位置的依赖。
经过 FFN 和第二个 Add & Norm,这一层编码器的输出仍是 10×512,作为下一层的输入。6 层走完,编码器输出的 10×512 就是整句话的表示。
九、解码器:三个子层,两种注意力
解码器结构和编码器大体对称,但有三处不同。
(1)Masked Self-Attention
解码器是自回归的:生成第 t 个词时,只能看到前 t-1 个词。但训练时整句译文是一次性喂进去的,如果不加限制,模型在第 t 个位置就能「看到」正确答案的第 t+1 个词,等于抄答案。
做法是在 softmax 之前,把当前位置之后的所有分数设成 −∞,softmax 之后这些位置的概率就变成 0。这就是 masked attention 的全部原理。
(2)Cross-Attention:K 和 V 从编码器来
这是最容易绕晕的地方,记住三个矩阵的来源就清楚了:
| 矩阵 | 来源 |
|---|---|
| Q | 解码器下一层的输出 |
| K | 编码器栈顶的输出 |
| V | 编码器栈顶的输出 |
也就是说,解码器拿自己当前的表示去「查询」编码器的输出,决定生成这个词时该看输入句子的哪些部分。这和经典的 seq2seq + attention 是同一件事,只是换成了多头、矩阵化的写法。
(3)输出层
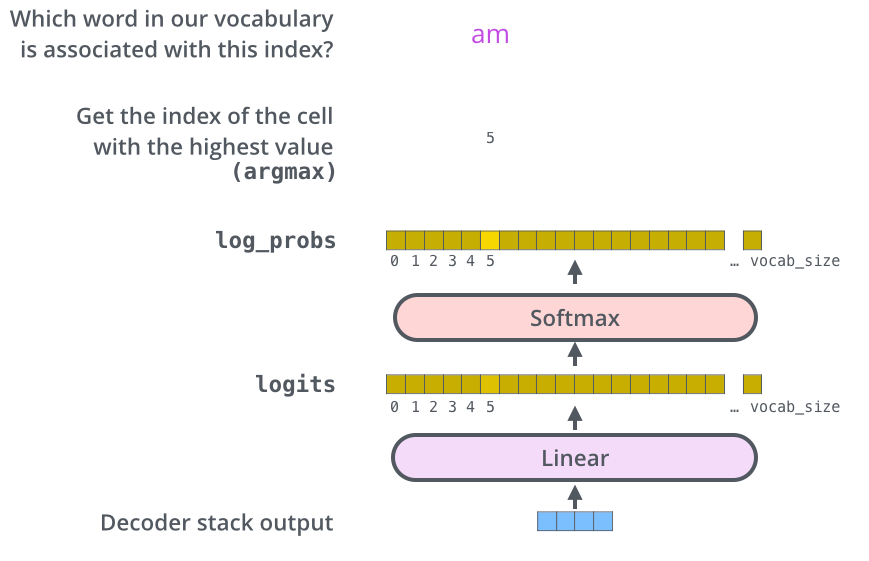
解码器栈顶输出的是一个 512 维浮点向量。要把它变成词,还需要:
- 一个 Linear 层,投影成词表大小的 logits 向量(比如 30000 维,每个格子对应一个词)
- softmax,变成概率分布
- 取概率最高(或按束搜索策略)的格子对应的词
十、训练与推理的差别
训练时整句输入、一次前向、并行计算所有位置的损失,与正确答案做交叉熵,反向传播更新权重。这种做法叫 teacher forcing,好处是所有位置能同时算。
推理时只能一个一个来:第 t 步的输出接回输入,跑第 t+1 步,直到生成结束符。这就是自回归——训练可以并行,推理天生串行,也是 Transformer 推理慢的根本原因。
选词策略上有两种常见做法:
- 贪心解码:每步取概率最高的词。简单,但一步走错后面全错。
- 束搜索(beam search):每步保留 top-k 个候选,分别往下跑,最后选整体得分最高的。k 是可调超参数。
十一、几个容易混淆的点
| 概念 | 常见误解 | 实际 |
|---|---|---|
| Q / K / V | 三者有明确语义 | 只是便于计算的抽象 |
| 多头拼接维度 | 8 头拼完是 2048 或 2560 | 取决于每个头的维度,8×64 = 512 |
| WO 的作用 | 把八个头揉在一起的融合器 | 八个并行的输出投影,融合靠相加 |
| 缩放因子 8 | 8 个头的意思 | 是 √dk,dk=64 时恰好为 8 |
| 残差的位置 | 混在拼接里 | 在子层输出之后 |
| 位置编码 | 可有可无的装饰 | 没有它模型就没有词序概念 |
| 编码器层数 | 6 是规定 | 超参数,可以调 |
| mask 的作用 | 防止过拟合 | 防止看到未来位置 |
| 推理能否并行 | 和训练一样 | 只能串行,逐 token 生成 |
结语
Transformer 的设计其实很克制:只有两个基本模块——注意力和前馈网络——重复堆叠,靠残差和归一化把深度撑起来。
理解它的关键,是把「一个 10×512 的矩阵怎么流过这些模块」完整走通一遍。走通之后再看 BERT、GPT 这些变体,会发现它们改动的往往只是三件事的排列组合:用编码器还是解码器、注意力怎么 mask、位置信息怎么注入。