PyTorch 快速上手:FashionMNIST 图像分类
记录 quickstart(Quickstart — PyTorch Tutorials)这个教程,便于后续快速套用结构。
数据集用 FashionMNIST,10 类服饰灰度图,28×28,训练 6 万张、测试 1 万张,模型是个三层全连接。
导包与全局设置
import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.utils.data import DataLoader, Dataset
from torchvision import datasets
from torchvision.transforms import v2
import numpy as np
import random
import matplotlib.pyplot as plt


# 设置随机种子
def set_seed(seed=27):
    torch.manual_seed(seed)
    torch.cuda.manual_seed_all(seed)
    np.random.seed(seed)
    random.seed(seed)


set_seed(27)

# 硬件配置
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"Using device: {device}")
输出:
Using device: cpu
torch.manual_seed 管 CPU 和权重初始化,torch.cuda.manual_seed_all 管多卡,np.random / random 管 numpy 和数据打乱相关的随机性。
数据准备
datasets.FashionMNIST 会自动下载并缓存到 root 目录。变换用 torchvision.transforms.v2,两步:
training_data = datasets.FashionMNIST(
    root="data",
    train=True,
    download=True,
    transform=v2.Compose([
        v2.ToImage(),                              # PIL Image -> Tensor(uint8), 形状 [C,H,W]
        v2.ToDtype(torch.float32, scale=True),     # 转 float32, 像素从 [0,255] 缩放到 [0,1]
    ]),
)

test_data = datasets.FashionMNIST(
    root="data",
    train=False,
    download=True,
    transform=v2.Compose([v2.ToImage(), v2.ToDtype(torch.float32, scale=True)]),
)
这里 v2 和老的 transforms 有一点区别:v2.ToDtype(torch.float32, scale=True) 一步就完成了「转类型 + 归一化」,不用再写 ToTensor()。scale=True 这个参数不能省,否则像素还是 0–255 的浮点数,训练会直接发散。
接着套 DataLoader 分批,并确认一下张量形状:
batch_size = 64

train_dataloader = DataLoader(training_data, batch_size=batch_size)
test_dataloader = DataLoader(test_data, batch_size=batch_size)

for X, y in test_dataloader:
    print(f"Shape of X [N,C,H,W]: {X.shape}")
    print(f"Shape of y: {y.shape} {y.dtype}")
    break
Shape of X [N,C,H,W]: torch.Size([64, 1, 28, 28])
Shape of y: torch.Size([64]) torch.int64
y 是 int64(即 long),这点很重要——CrossEntropyLoss 只接受 long 类型的类别索引,不接受 one-hot,也不接受 float。
网络结构
class NeuralNetwork(nn.Module):
    def __init__(self):
        super().__init__()
        self.flatten = nn.Flatten()      # 把除 batch 维以外的维度全部拉平
        self.linear_relu_stack = nn.Sequential(
            nn.Linear(28 * 28, 512),
            nn.ReLU(),
            nn.Linear(512, 512),
            nn.ReLU(),
            nn.Linear(512, 10),
        )

    def forward(self, x):
        x = self.flatten(x)
        logits = self.linear_relu_stack(x)
        return logits


model = NeuralNetwork().to(device)
print(model)
nn.Flatten() 默认从第 1 维开始拉平,所以 [64,1,28,28] 进来变成 [64,784],batch 维保留。最后一层输出 10 个 logits,不要接 softmax——CrossEntropyLoss 内部已经做了 log-softmax,重复做一次会让梯度变小、收敛变慢。
print(model) 能看到完整结构:
NeuralNetwork(
  (flatten): Flatten(start_dim=1, end_dim=-1)
  (linear_relu_stack): Sequential(
    (0): Linear(in_features=784, out_features=512, bias=True)
    (1): ReLU()
    (2): Linear(in_features=512, out_features=512, bias=True)
    (3): ReLU()
    (4): Linear(in_features=512, out_features=10, bias=True)
  )
)
model.to(device) 是原地操作、返回 self,所以两种写法等价;但数据也要 .to(device),两者不在同一设备上会直接报错。
训练与评估
损失函数和优化器:
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.SGD(model.parameters(), lr=1e-3)
训练循环的四步顺序是固定的,写熟了就是肌肉记忆:
def train(dataloader, model, loss_fn, optimizer):
    size = len(dataloader.dataset)
    model.train()
    for batch, (X, y) in enumerate(dataloader):
        X, y = X.to(device), y.to(device)

        # 前向 + 损失
        pred = model(X)
        loss = loss_fn(pred, y)

        # 反向 + 更新 + 清零
        optimizer.zero_grad()      # 清空上一轮梯度
        loss.backward()
        optimizer.step()

        if batch % 100 == 0:
            loss_val, current = loss.item(), (batch + 1) * len(X)
            print(f"loss: {loss_val:>7f}  [{current:>5d}/{size:>5d}]")


def test(dataloader, model, loss_fn):
    size = len(dataloader.dataset)
    num_batches = len(dataloader)
    model.eval()

    test_loss, correct = 0, 0
    with torch.no_grad():
        for X, y in dataloader:
            X, y = X.to(device), y.to(device)
            pred = model(X)
            test_loss += loss_fn(pred, y).item()
            correct += (pred.argmax(1) == y).type(torch.float).sum().item()

    test_loss /= num_batches
    correct /= size
    print(f"Test Error:\n Accuracy: {(100 * correct):>0.1f}%, Avg loss: {test_loss:>8f}\n")
三个细节值得记:
optimizer.zero_grad()放哪都行,但放在backward()之前更不容易漏;漏了梯度会跨 batch 累加。- 评估必须
model.eval()+torch.no_grad(),前者关掉 dropout / 改 BatchNorm 行为,后者省显存。 - 统计 loss 时用
.item()取出 Python 标量,否则整个计算图会被一直挂着,显存越跑越多。
跑 5 轮:
epochs = 5
for t in range(epochs):
    print(f"Epoch {t + 1}\n-------------------------------")
    train(train_dataloader, model, loss_fn, optimizer)
    test(test_dataloader, model, loss_fn)
print("Done!")
结果汇总:
| 轮次 | 测试准确率 | 平均损失 |
|---|---|---|
| 1 | 41.2% | 2.164549 |
| 2 | 50.9% | 1.906974 |
| 3 | 58.9% | 1.539680 |
| 4 | 63.6% | 1.270485 |
| 5 | 65.1% | 1.100129 |
单轮日志长这样(第 5 轮):
Epoch 5
-------------------------------
loss: 1.336771  [   64/60000]
loss: 1.329332  [ 6464/60000]
loss: 1.161400  [12864/60000]
loss: 1.278819  [19264/60000]
loss: 1.150099  [25664/60000]
loss: 1.176580  [32064/60000]
loss: 1.187575  [38464/60000]
loss: 1.121785  [44864/60000]
loss: 1.168132  [51264/60000]
loss: 1.079935  [57664/60000]
Test Error:
 Accuracy: 65.1%, Avg loss: 1.100129
65% 确实偏低(FashionMNIST 上 MLP 一般能到 85% 左右),主要原因是 SGD + lr=1e-3 太小、只跑了 5 轮,曲线还在稳步下降、远没收敛。换成 Adam(lr=1e-3) 或把轮次加到 15 轮,数字会明显不同。这份代码的目标是跑通流程,不追指标。
保存与加载
只存参数,不存整个模型对象——存 state_dict 体积小、依赖少,跨版本、跨代码结构都更稳。
torch.save(model.state_dict(), "model.pth")
print("Saved PyTorch Model State to model.pth")
Saved PyTorch Model State to model.pth
加载时先用同一套结构实例化,再灌参数:
model = NeuralNetwork().to(device)
model.load_state_dict(torch.load("model.pth", weights_only=True))
<All keys matched successfully>
weights_only=True 是个安全设置:只反序列化张量,不执行任意 pickle 代码。PyTorch 2.6 之后默认就是 True,所以老代码里显式写 weights_only=False 的地方要留意。
推理与可视化
classes = [
    "T-shirt/top", "Trouser", "Pullover", "Dress", "Coat",
    "Sandal", "Shirt", "Sneaker", "Bag", "Ankle boot",
]

model.eval()
x, y = test_data[1][0], test_data[1][1]
with torch.no_grad():
    x = x.to(device)
    pred = model(x)
    predicted, actual = classes[pred[0].argmax(0)], classes[y]
    print(f'Predicted: "{predicted}", Actual: "{actual}"')
Predicted: "Pullover", Actual: "Pullover"
注意这里 test_data[1][0] 是 [1,28,28] 的单张图(没有 batch 维),所以前向输出是 [1,10],取 pred[0] 才是这一张图的 10 个 logits,再 argmax(0) 拿到类别下标。
最后抽 9 张训练图看看数据长什么样:
labels_map = {
    0: "T-Shirt", 1: "Trouser", 2: "Pullover", 3: "Dress", 4: "Coat",
    5: "Sandal", 6: "Shirt", 7: "Sneaker", 8: "Bag", 9: "Ankle Boot",
}

figure = plt.figure(figsize=(8, 8))
cols, rows = 3, 3
for i in range(1, cols * rows + 1):
    sample_index = torch.randint(len(training_data), size=(1,)).item()
    img, label = training_data[sample_index]
    figure.add_subplot(rows, cols, i)
    plt.title(labels_map[label])
    plt.axis("off")
    plt.imshow(img.squeeze(), cmap="gray")
plt.show()
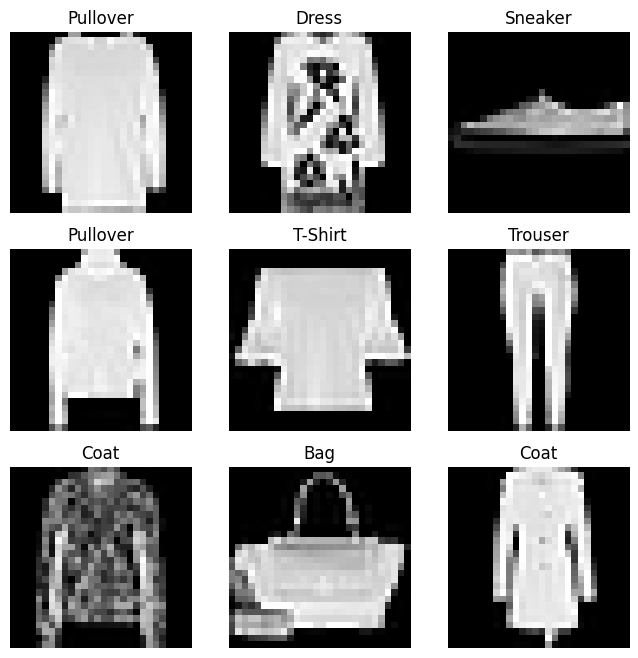
img 的形状是 [1,28,28],imshow 需要二维数组,所以先 squeeze() 掉通道维;灰度图要指定 cmap="gray",否则 matplotlib 会用彩色映射表,看着不像衣服。
小结
整份流程就是六步,写别的任务时把中间两块换掉即可:
| 步骤 | 这段代码做什么 | 换任务时改什么 |
|---|---|---|
| 数据 | datasets.FashionMNIST + DataLoader |
换成自己的 Dataset,注意标签是 long |
| 模型 | 三层 MLP,784→512→512→10 | 换成 CNN / Transformer,输出维度 = 类别数 |
| 损失 | CrossEntropyLoss |
回归换 MSELoss,多标签换 BCEWithLogitsLoss |
| 优化 | SGD(lr=1e-3) |
一般直接上 AdamW,常配 cosine 调度 |
| 训练 | 前向→损失→清梯度→反向→更新 | 加大 batch、混精度、梯度裁剪 |
| 保存 | state_dict + weights_only=True |
结构改了要同步改实例化代码 |
顺带记三个这次遇到的坑:v2.ToDtype 不写 scale=True 会导致像素不归一化;模型和数据忘了同时 .to(device) 会报设备不一致;CrossEntropyLoss 前面多接一个 softmax 会让收敛变慢。