深度学习基础结构:RNN 结构
基本原理
下图左侧是 RNN 的折叠画法,右侧是它按时间展开后的样子:
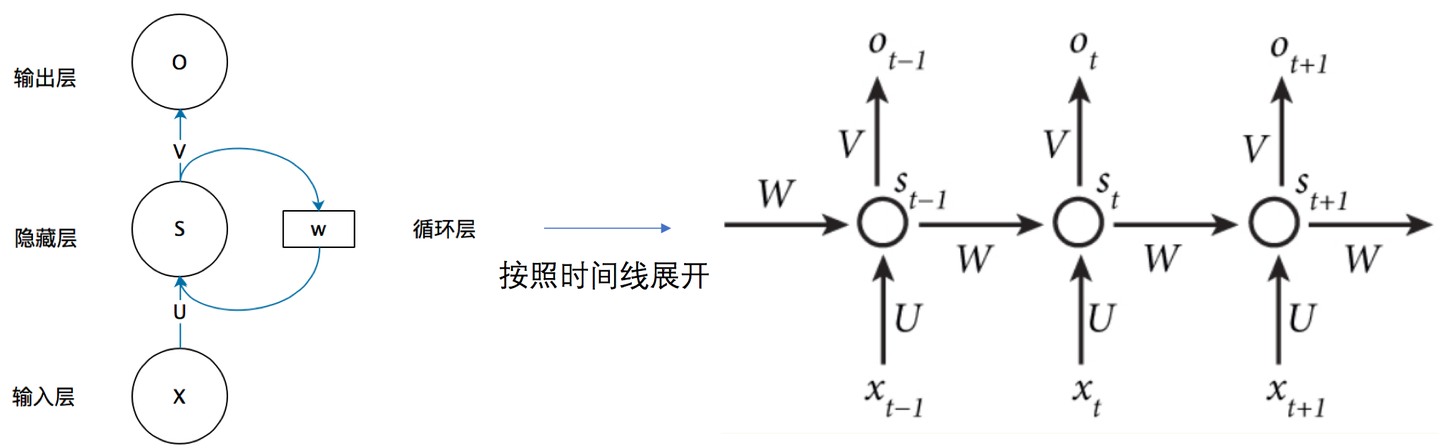
左侧三层分别是输入层、隐藏层、输出层:X 是当前时刻的输入向量,S 是隐藏状态,O 是这一时刻的输出。U、V、W 是三个待学习的权重矩阵:
- U:输入 → 隐藏,决定这一步的词向量对隐藏状态贡献多大。它和 embedding 不同:embedding 是查表,U 是可训练的线性变换;
- W:隐藏 → 隐藏,决定上一步的隐藏状态以多大比例进入当前状态——就是图上那个画成拐弯箭头的圈;
- V:隐藏 → 输出,把状态投射到输出空间,之后按任务接 softmax、sigmoid,或者都不接。
关键在 S 上那个圈。把它去掉,剩下的就是一个最普通的前馈网络:X 进、过一层、O 出,算完这一步 S 就被丢掉了,下一个词再从零开始。加上这个圈,S 除了送进 V,还会原路回到下一步的输入端——信息不会随这一步结束而消失。所谓记忆,不是存了一张表,而是每一步都把上一步的结果重新算进去。
公式表示如图:
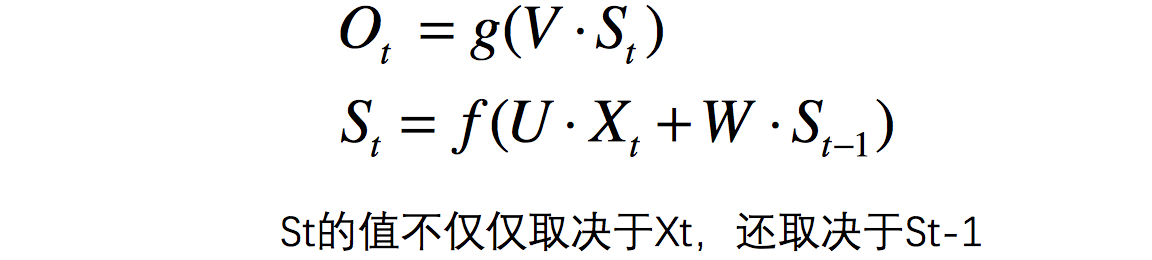
图里省略了偏置,完整写法是 St = f(U·Xt + W·St-1 + b)。
第 t 步的隐藏状态 St,由「当前输入」和「上一步的隐藏状态」共同决定。 也就是说,St 里压缩着前 t 步的信息。注意这是有损压缩——每传一步就被覆盖一次,句子一长,早期内容自然变淡。f 一般是 tanh(早期用 sigmoid);g 由任务定,互斥分类接 softmax,二分类和多标签接 sigmoid,回归不加激活。
需要注意的是:U、V、W 在所有时间步是同一套。 右侧把隐藏层复制了三份,复制的是结构,不是参数。这正是 RNN 能处理任意长度句子的原因——参数不随句子变长而增加,第 5 个词和第 50 个词用的是同一套「怎么理解一个词、怎么接上前文」的规则。这种共享常被叫作「沿时间共享权重」,是 CNN 沿空间共享权重的对应物。
为什么不能直接用全连接网络?
- 长度可变。 全连接层要的是一个定长向量:10×512 得先拉平成 5120 维,换成 12 个词就是 6144 维,权重矩阵形状直接对不上,只能截断或补齐,两种都是妥协。
- 参数爆炸。 就算定死长度、让每个位置各有一组权重,位置之间也学不到共同规律——「主谓一致」在第 2 个词和第 9 个词上是同一条规则,却要被两套独立参数各学一遍。
- 没有记忆。 前馈网络的输出只由当前输入决定,与之前算过什么无关。处理第 t 个词时,模型对前 t-1 个词一无所知。
RNN 的三个机制一对一解掉它们:隐藏状态给了记忆——「St 依赖 St-1」这条递推本身,就是对「序」的建模;一次只吃一个词的推进方式解决了定长输入;沿时间共享同一套 U/V/W 挡住了参数爆炸。
代价也随之而来:St 必须等 St-1 算完,时间步之间串行,训练无法并行;反向传播又要沿时间连乘,梯度容易消失或爆炸——LSTM 的门控就是为了挡这一下。这两点正是后面 Transformer 要解决的问题。
RNN 的 PyTorch 实现
先用现成的 nn.RNN
import torch, torch.nn as nn
torch.manual_seed(0)

B, T, D, H = 2, 10, 512, 64      # batch、时间步、词向量维度、隐藏维度
x = torch.randn(B, T, D)

rnn = nn.RNN(D, H, batch_first=True, nonlinearity="tanh")
out, h_n = rnn(x)
print(out.shape, h_n.shape)      # [2, 10, 64]  [1, 2, 64]
out 是每个时间步的输出(对应图上的 Ot 序列),h_n 是最后一个时间步的隐藏状态。单层单向时,h_n[0] 和 out[:, -1] 是同一个张量——记住这点,后面取句向量就不用纠结该用哪个。
按公式手写一遍
输出和上面完全一致,这一段是为了让那几个矩阵对上号:
def rnn_forward(x, rnn):
    B, T, _ = x.shape
    W_ih, W_hh = rnn.weight_ih_l0, rnn.weight_hh_l0   # 就是 U 和 W
    b = rnn.bias_ih_l0 + rnn.bias_hh_l0               # 两个偏置先加一起
    h = torch.zeros(B, rnn.hidden_size)               # S_0 默认全零
    outs = []
    for t in range(T):
        h = torch.tanh(x[:, t] @ W_ih.T + h @ W_hh.T + b)
        outs.append(h)
    return torch.stack(outs, dim=1), h.unsqueeze(0)

out2, h2 = rnn_forward(x, rnn)
print(torch.allclose(out, out2, atol=1e-5), torch.allclose(h_n, h2, atol=1e-5))
# True True
对照公式 S_t = f(U·X_t + W·S_{t-1} + b):x[:, t] @ W_ih.T 是 U·Xt,h @ W_hh.T 是 W·St-1,torch.tanh 是 f。循环里那个 h 被反复覆盖,就是「同一套参数在时间步上复用」的字面体现。
接输出层
把隐藏状态变成结果:
class RNNRegressor(nn.Module):
    def __init__(self, input_size, hidden_size):
        super().__init__()
        self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
        self.head = nn.Linear(hidden_size, 1)     # 回归:不加激活

    def forward(self, x):
        out, _ = self.rnn(x)
        return self.head(out[:, -1])              # 取最后一步
换任务只改这一行:分类用 nn.Linear(hidden_size, n_class),输出 logits 交给 CrossEntropyLoss;多标签用 BCEWithLogitsLoss,同样不要自己先接 sigmoid。
三个实践要点
- 变长句子要 pack。 上面的写法默认整个 batch 长度一致。真实语料长度不齐,要么用
pack_padded_sequence,要么补齐后让 padding 位置不计入 loss。 - 梯度裁剪是标配。 反向传播沿时间连乘,爆炸比消失更致命。一行
torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)基本必加。 - 别手动 softmax。 分类只需要输出 logits,
CrossEntropyLoss内部已经做了 log_softmax,自己先 softmax 反而在概率接近 0 时算出-inf。